SynthID Bio 是甚麼?為 AI 設計蛋白質嵌入可驗證浮水印
2026年10月08日
Google DeepMind 9 月 30 日發佈 SynthID Bio,為 AI 設計的蛋白質序列與預測結構嵌入可驗證浮水印。本文拆解 SynthID Bio 是甚麼與背後的生物安全邏輯。
AI 現在能設計出自然界從未存在的蛋白質。這件好事也帶來一個麻煩:當一個合成設計看起來不像已知威脅時,合成生物學的把關者更難判斷它是不是有人刻意做出來的危險品。Google DeepMind 在 9 月 30 日端出 SynthID Bio,把浮水印技術帶進合成生物學,讓 AI 設計的蛋白質能自帶可驗證的簽名。研究已發表在《Nature》。
SynthID Bio 是甚麼
SynthID Bio 是 Google DeepMind 專為合成生物學開發的一系列浮水印方法,目標是強化生物安全與科學誠信。
它的核心是把一個不易察覺的簽名,直接嵌入生物設計的代碼裡。這個 SynthID Bio 浮水印不只在數位模型上可驗證,連合成出來的實體蛋白質本身都能查驗,而且在實驗室測試中不影響蛋白質的生物功能。這點很關鍵:一個會破壞功能的浮水印,等於沒人敢用。
它不是單一技術,而是一套會依資料類型調整策略的方法。面對胺基酸序列,它微妙地引導胺基酸的選擇;面對預測的 3D 結構,它調整原子座標。兩者都產生可靠的偵測信號,而且研究團隊反覆測試過,這些微調不會讓蛋白質失控。
SynthID Bio 怎麼運作
先講它要解決的問題。
生成式 AI 幫科學家做很多事,從預測蛋白質結構到設計全新蛋白質,甚至開發新的噬菌體。Google DeepMind 蛋白質設計工具越快,這些風險也越明顯:全新的 AI 設計可能繞過傳統的 DNA 合成篩查,而標記錯誤的合成 3D 結構會污染公開資料庫、誤導後續研究。
SynthID Bio 分兩條線應對。
在蛋白質序列上,它用一種能產生浮水印的蛋白質序列生成方法。研究團隊結合一開始做蛋白質黏合劑設計的 AlphaProteo,以及一個啟用 SynthID Bio 的 ProteinMPNN 版本,來產生帶浮水印的設計。在三個目標蛋白(VEGF-A、SARS-CoV-2 棘蛋白 RBD,以及 PD-L1)的濕實驗測試中,帶浮水印的設計在命中率、結合親和力與自然序列多樣性上,都跟未加浮水印的版本相符,成功做出史上第一批帶浮水印且具生物功能的蛋白質黏合劑。
在蛋白質摺疊上,SynthID Bio 微調 AlphaFold 3 擴散網路的一小部分,把浮水印能力直接建進模型的權重裡。這確保預測出的 3D 座標本身帶有可偵測的簽名,不論是誰跑這個模型都一樣。它保留了 AlphaFold 3 的預測準確度,同時達到近乎完美的可偵測性,也能抵擋數位雜訊或輕微座標變動。
SynthID Bio 為甚麼對生物安全重要
SynthID Bio 生物安全的價值,在於它補上的那一層防禦。
生物安全靠的是多層防禦,研究團隊用瑞士芝士模型來比喻:多道獨立的安全措施互相補位,蓋住彼此的盲點。模型層面的減害、客戶審查,各是一層,但每層都有缺口。SynthID Bio 補上的是嵌在生物設計本身的那一層可驗證機制。
這對 DNA 合成篩查特別關鍵。把數位蛋白設計變成實體分子,得向 DNA 合成供應商下單,供應商會對照已知威脅的資料庫來篩查請求。過去的邏輯是:一個陌生的序列,通常可以安全地假設它是某個未被發現的天然生物。但 AI 能造出與已知風險幾乎毫無相似度的全新序列,篩查者再也不能這樣假設。要驗證一個陌生訂單不是被工程化的威脅,往往需要耗時的人工審查,拖慢重要研究。SynthID Bio 在這裡能提供一個自動化的驗證信號,證明訂單來自一個內建防護的受信任模型。
SynthID Bio 功能與實際應用場景
把 SynthID Bio 功能放進真實流程裡,價值就清楚了。
- 模型開發者用它設計蛋白質,出的每一個 AI 蛋白質 浮水印設計都自帶可追溯的來源信號
- DNA 合成供應商收到陌生訂單時,能自動判斷它是否來自受信任模型,把審查資源集中在真正需要細看的序列上
- 資料庫管理者可以用它辨識出被錯誤標記的合成 3D 結構,減少對後續研究的污染
DeepMind 已把 SynthID Bio 工具開源,讓研究社群能在此基礎上繼續發展。想研究的人可以到 Google DeepMind 官網查閱技術報告,把工具下載回來自行測試與驗證。對需要管理大量 AI 生成設計的機構,這種設計自帶來源證明的思路,比事後比對更省力。這也正是合成生物學 AI 走向規模化時必須補上的一環。
浮水印怎麼在實體蛋白質上被驗證
一段浮水印如果只在電腦裡有效,意義不大。SynthID Bio 的關鍵測試,是在濕實驗室裡做的。
研究團隊把帶浮水印的蛋白質黏合劑合成出來,實際量測它們的結合親和力。結果顯示,加了浮水印的設計,在命中率、結合強度與序列多樣性上,都跟沒加浮水印的版本相差無幾。也就是說,簽名藏在序列裡,蛋白質該做的事一樣做得到。這件事聽起來理所當然,但要在生物層面做到不影響功能,技術難度不低。
SynthID Bio 的限制與注意事項
浮水印是防禦的其中一層,不是萬靈丹。
它證明的是這份設計來自某個受信任模型,不是這份設計一定安全。要擋住惡意用途,還是得靠模型層面的拒答設計、客戶審查與其他安全措施一起運作。另外,目前公開的驗證集中在蛋白質黏合劑與蛋白質結構這兩類,其他生物設計類型能不能套用,還需要更多研究。
研究團隊也強調,業界應在能力提升的關鍵時刻,維持推理的透明度,讓安全監測能持續運作。浮水印能做的事,是讓協作式防禦更有效率,不是取代人的把關。開放工具也意味著門檻降低,機構在導入時要自己評估驗證流程與資料權限的安全範圍。
SynthID Bio 跟一般 AI 浮水印有甚麼不同
一般內容浮水印處理的是圖片、音訊、文字,目標是標記數位檔案。SynthID Bio 處理的是生物序列與結構,難度高一個級別。
差別在於,數位浮水印只要撐過壓縮、裁切、轉檔;生物浮水印得撐過合成、摺疊、量測這些實體流程,還不能改變蛋白質本身的功能。研究團隊做到了這件事,才讓浮水印從數位世界延伸到實驗台。這也是它被《Nature》接受的原因之一:不是概念驗證,是有濕實驗數據支撐的成果。
SynthID Bio 對一般人有甚麼意義
大多數人不會直接用到 SynthID Bio,但它的影響其實貼近生活。
AI 設計的蛋白質正在走向藥物、診斷與材料。當這些設計能自帶可驗證的來源,從研發到供應鏈的把關就更順暢,最終受益的是需要這些療法的病人。想知道完整研究的人,可以到 Google DeepMind 官網取得開源工具,實際摸索它的驗證流程。
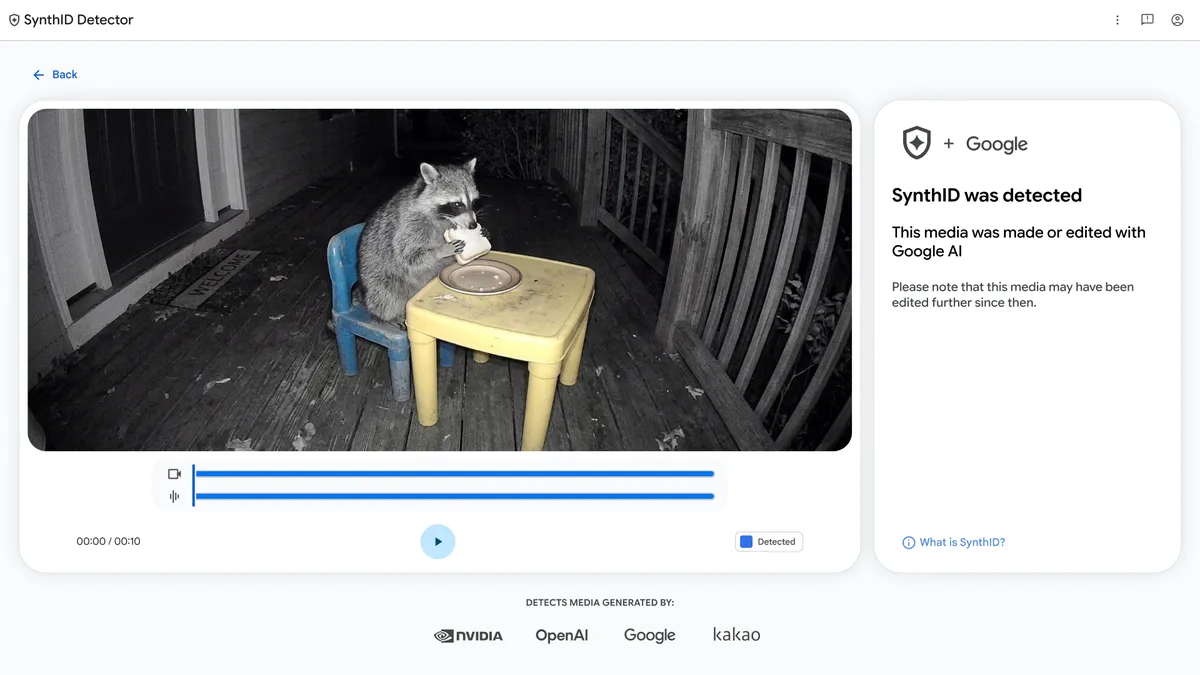
Google DeepMind 這次把浮水印從圖像、音訊延伸到生物代碼,等於替 AI 生成內容的來源追溯,補上了一塊新的拼圖。過去談 SynthID,多數人想到的是辨識一張圖是不是 AI 畫的;現在同樣的思路被搬到分子尺度,管的是蛋白質設計從哪裡來。這個跨度本身就說明了 AI 生成內容的來源問題,已經不只停在媒體與版權,而是碰觸到實驗室與供應鏈。對生技公司與研究機構來說,這代表往後每一份 AI 設計,都可能自帶一條查得到的來歷。SynthID Bio 值得記住這個名字,它是這條路上最新的路標。
 NEWS
 REVIEWS
 HOWTO